
Transcritor de áudio e legendas com Whisper
Pipeline local que converte vídeos em áudio, transcrição TXT e legenda SRT usando FFmpeg e Whisper.
- Papel
- Implementação, testes e documentação
- Stack
- Python · OpenAI Whisper · FFmpeg · unittest
- Resultado
- Fluxo reproduzível de vídeo para MP3, TXT e SRT com uma CLI e quatro testes.
Problema
Produzir uma legenda reutilizável normalmente exige coordenar extração de áudio, reconhecimento de fala e escrita dos formatos de saída. O protótipo inicial extraía o áudio, mas não retornava o caminho do MP3 para a transcrição, executava automaticamente ao ser importado e dependia de pastas criadas manualmente.
Solução
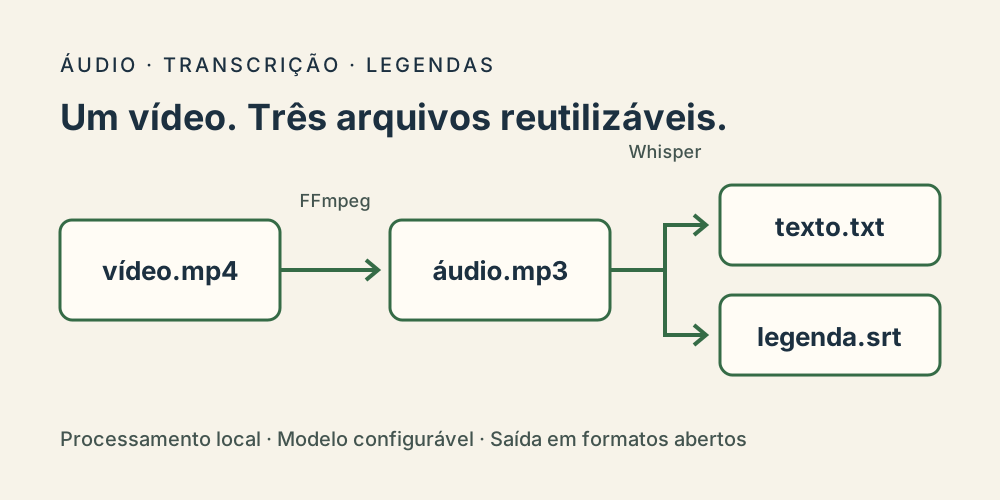
vídeo
  │
  ▼
FFmpeg ──► MP3
             │
             ▼
          Whisper
             │
             ├──► legenda SRT
             └──► transcrição TXT
A extração cria seu diretório, executa o FFmpeg com verificação de erro e devolve o caminho produzido. A CLI conecta esse resultado ao Whisper e permite escolher modelo e diretórios sem alterar o código.
Confiabilidade
- nenhuma execução acontece durante a importação dos módulos;
- falhas do FFmpeg são propagadas para o terminal;
- diretórios de áudio e texto são criados automaticamente;
- arquivos de entrada e saída permanecem fora do Git;
- testes usam substitutos para FFmpeg e Whisper, sem baixar modelos ou mídia.
Resultado
Uma entrada video.mp4 produz, na configuração padrão:
audios/
└── video.mp3

srts/
├── video.srt
└── video.txt
Quatro testes verificam o caminho retornado pela extração, a propagação de erros, a escrita da transcrição e a integração entre argumentos, áudio e legenda.
Limitações
O projeto processa um arquivo por execução e carrega o modelo novamente a cada chamada. O modo atual usa fp16=False para privilegiar compatibilidade com CPU, e a qualidade depende do idioma, do ruído e do modelo escolhido.